- 16G 的 M2 Pro 上跑 4-bit 量化版,测了 14 张:4 到 10 个字的中文标题和促销海报基本一次写对。
- 22 个字的长句、「饕餮」这类生僻字、英文单词都会翻车;一张图 2 分多钟,跑的时候电脑干不了别的。
- 单算钱本地划不来,云端一张 0.1 元;值得折腾的是图不出本机、不排队、没有审核卡你。
短标题、促销海报能直接用;长文案、生僻字、中英混排别指望。单算钱不如云端,值在图不出本机。
实测清单
2 通过 · 3 翻车- 通过4–10 字中文短标题基本一次写对
- 通过带数字和日期的促销海报两个种子都对,横杠没丢
- 翻车22 字中文长句两张都错,错法还不一样
- 翻车生僻字「饕餮」画出字典里查不到的字
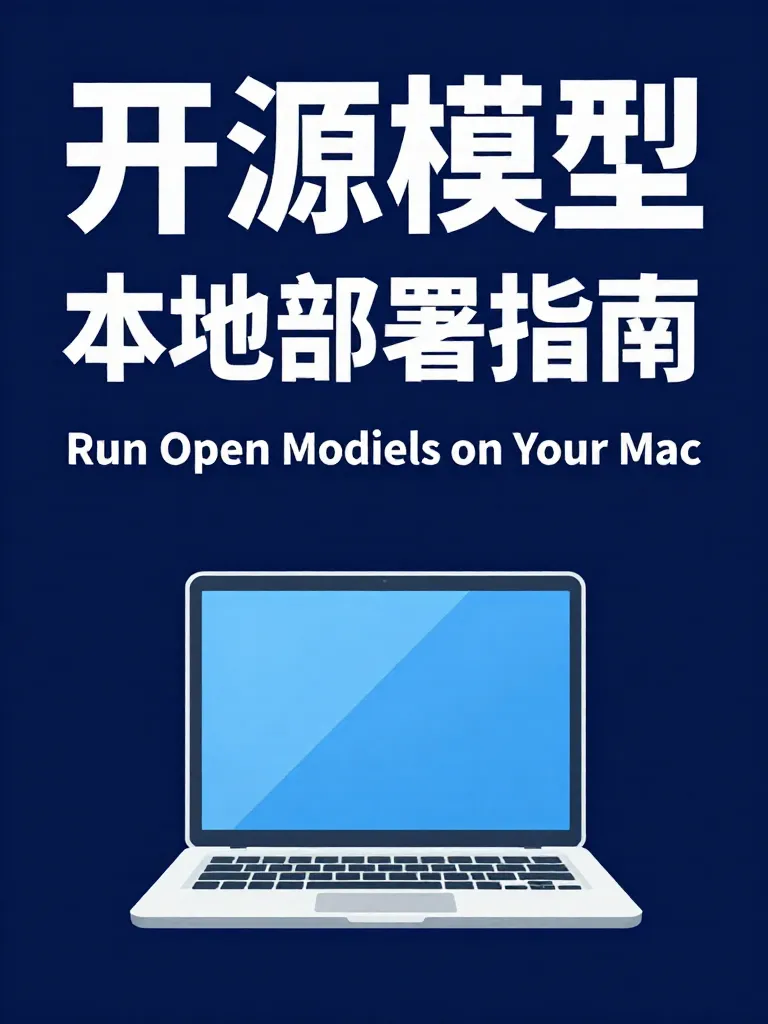
- 翻车英文单词Models 拼成 Modiels
- 凑合速度(16G M2 Pro)一张 2 分多钟,跑时干不了别的
| 项目 | 结果 |
|---|---|
| 测了什么 | 14 张:4 个日常场景 + 5 档中文字难度 × 2 个种子 |
| 单张耗时 | 120–240 秒(含每次加载模型),补测 10 张平均 130 秒 |
| 内存 | 峰值占用 12.4–12.7 GB(16GB 机器,出图时别开别的重活) |
| 整机功耗 | 出图时约 55 W(电池供电实测),空闲约 10 W |
| 中文字 | 12 张带字的图,5 张一个字不错;4 字标题、促销海报全对,22 字长句和生僻字全军覆没 |
| 典型错误 | 漏字、多写一遍、编出不存在的字、英文单词拼错 |
| 花费 | 0 元;按北京居民电价算,一张约 0.001 元电费 |
先说结果
4 到 10 个字的中文标题,它基本一次就写对。
带数字和日期的促销海报,两个种子都对,连「11月1日-11月11日」里的横杠都没丢。
一句 22 个字的话,两张都写错了,错法还不一样。
「饕餮」两个字,它两次都画了个长得像、但字典里查不到的字。
英文反而翻车:「Models」两次拼成了「Modiels」和「Madiels」。
一张图 2 分多钟,16G 的 Mac 能跑,跑的时候基本干不了别的。
怎么测的
机器是一台 M2 Pro、16G 内存的 MacBook Pro,补测那轮没插电。
模型用魔搭上社区做的 4-bit 量化版,跑在 mflux 上,9 步,768×1024 竖图。
第一轮 4 个日常场景,种子 42,各 1 张。
第二轮专门压中文字,5 档难度,每档种子 1 和 2 各 1 张,一张跑完再跑下一张:
- 4 字短标题「今日营业」
- 促销海报「双十一狂欢 全场5折起」+「活动时间:11月1日-11月11日」
- 中英两行「开源模型本地部署指南」+「Run Open Models on Your Mac」
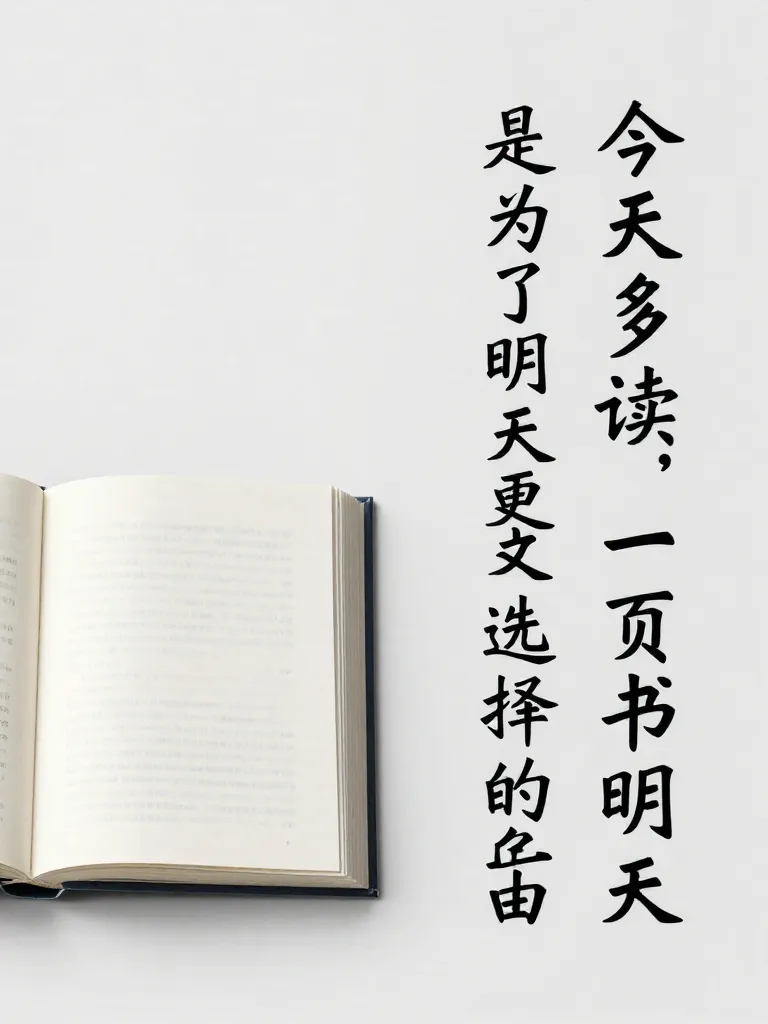
- 22 字长句「今天多读一页书,是为了明天能有更多选择的自由」,竖排书法
- 生僻字加繁体「饕餮盛宴」+「龍鳳呈祥 鬱鬱蔥蔥」
每张图逐字对,一个字不差才算“完全正确”。
14 张样本还是少,结论当成手感,别当跑分。
中文字到底行不行
短的稳
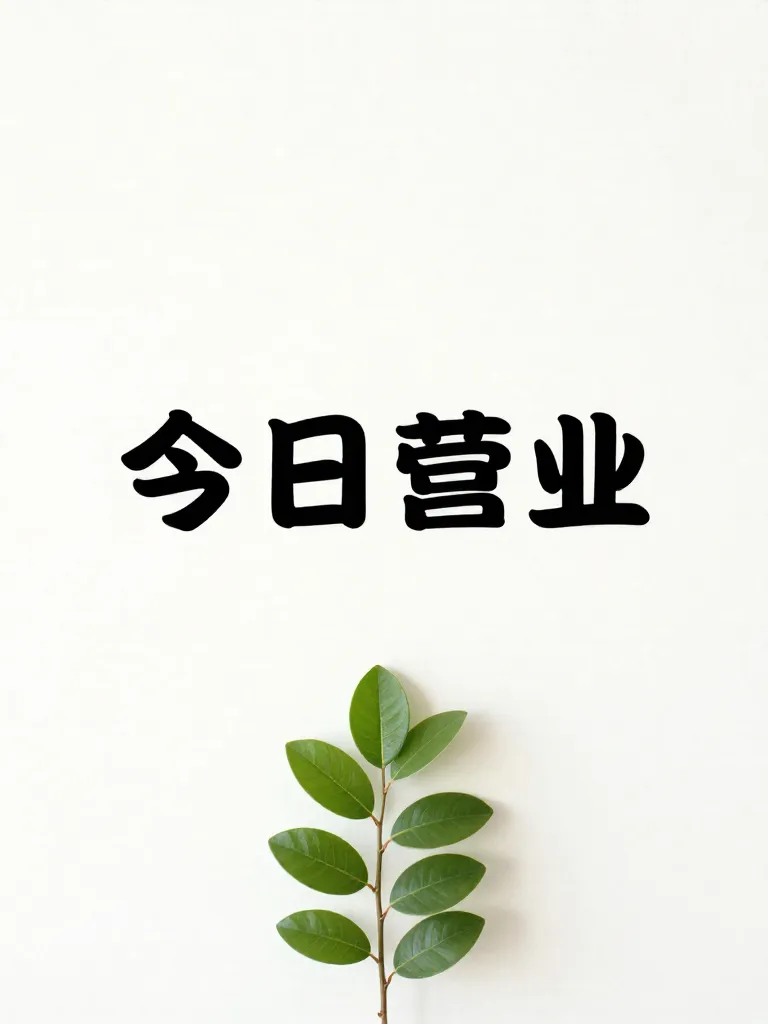
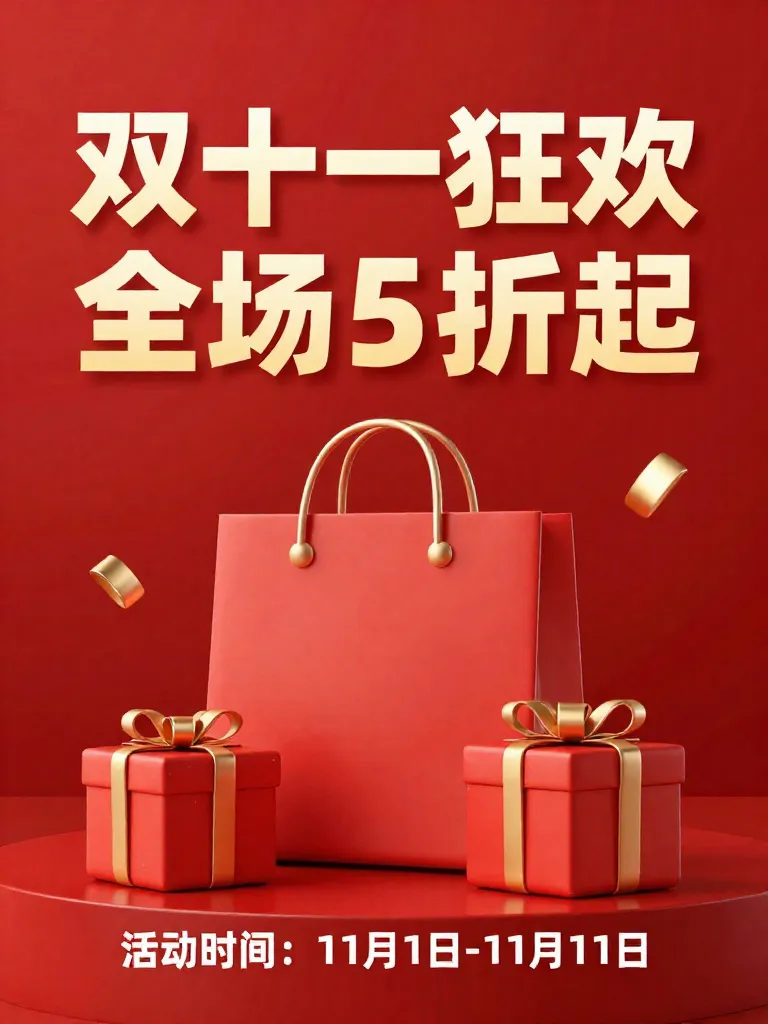
4 字标题两张全对,字形干净,像正经字体。
双十一那张信息量不小,10 个字的主标题、阿拉伯数字、冒号、日期区间,两张都一个不错。
第一轮的小红书封面「月入3万的AI小工具」也是一次对。
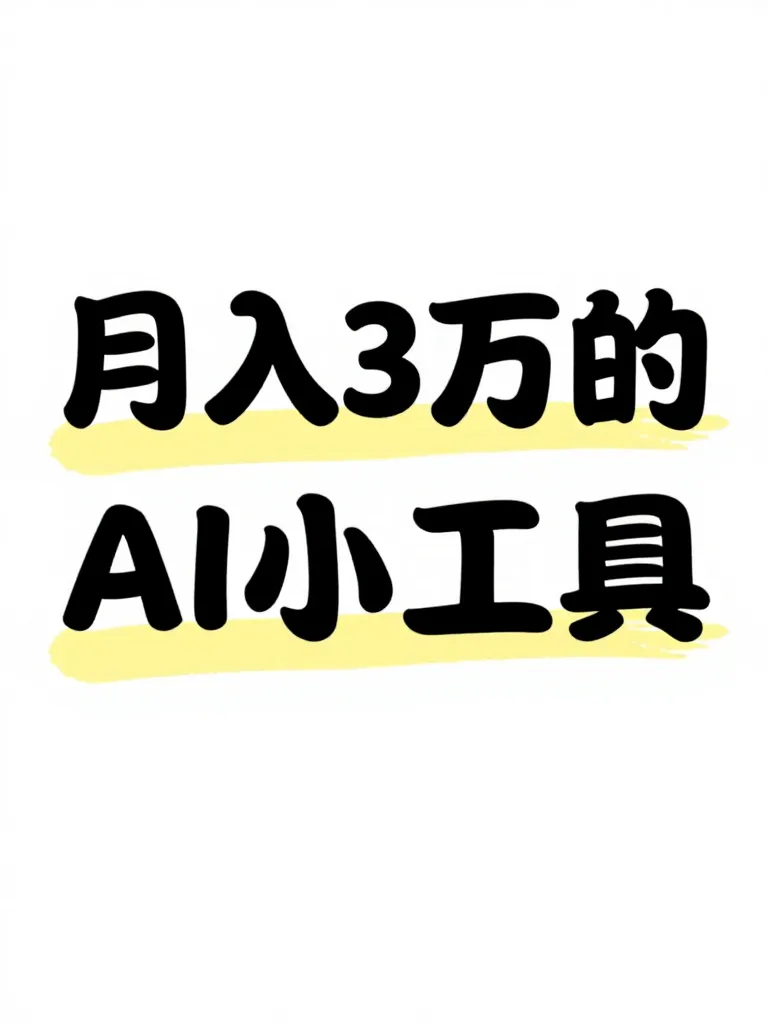
这一档的活,它已经可以直接拿去用了,省掉打开修图软件排字那一步。
稍长一点开始出状况
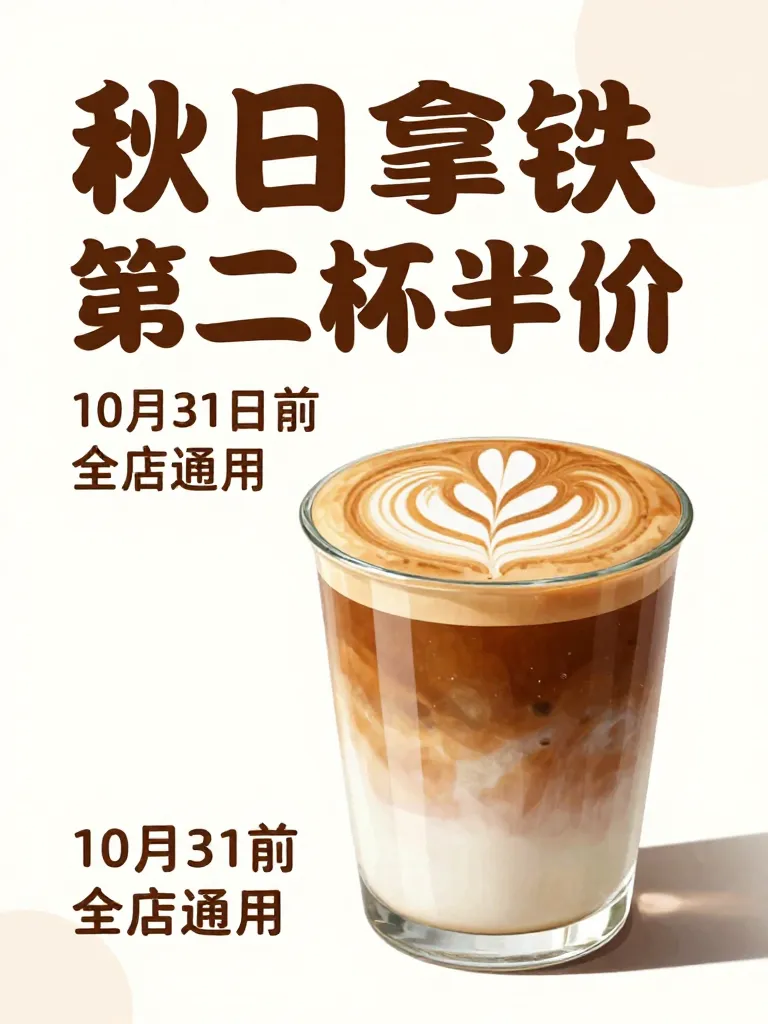
第一轮的咖啡海报,主标题 8 个字全对,但日期那行它在左下角又抄了一遍,第二遍还把「10月31日前」写成「10月31前」。
中英混排那档更有意思。
中文「开源模型 本地部署指南」两张都对,英文那行两张都错。
Decrypt 的 Jose Antonio Lanz 去年 12 月测过,他的说法是英文很强,只有「decentralized」这种长而少见的词会拼错。
我们这次错的是「Models」这种大路货单词。
是 4-bit 量化的锅,还是模型本来就这样,没法下结论,这次没跑全精度版对照。
长句和生僻字,全错
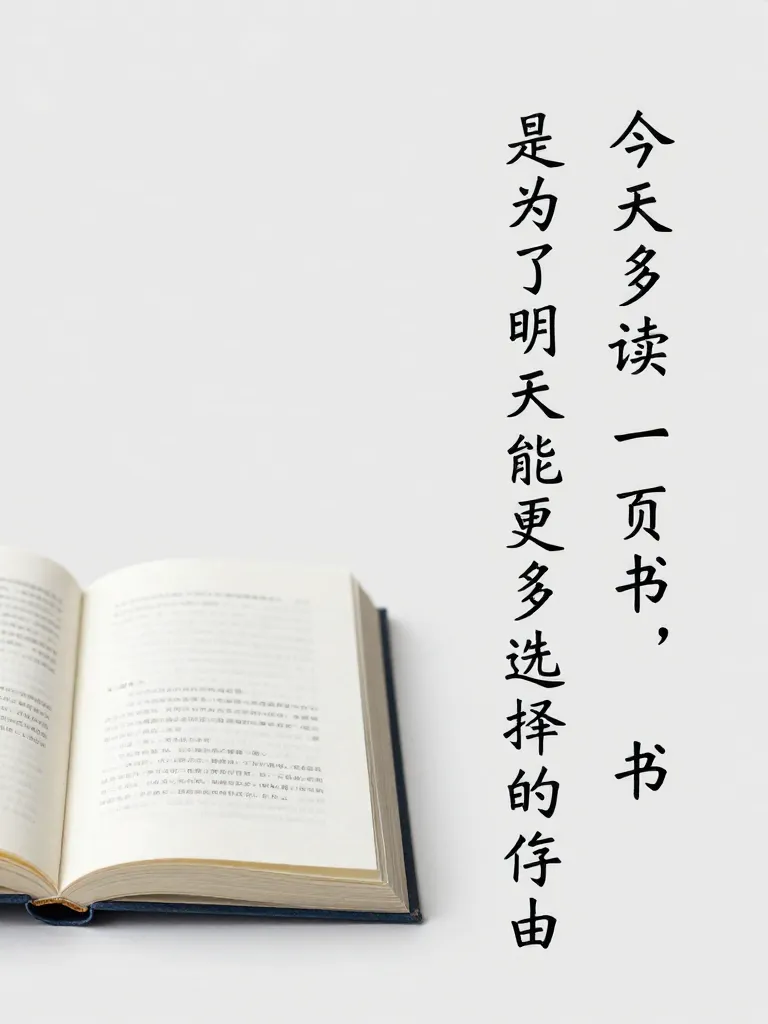
种子 1:漏了「有」,「自由」的「自」写成一个单人旁的怪字,第一列末尾还多出一个「书」。
种子 2:漏了「能有」,「多」写成「文」,「自」又是个造出来的字,第一列还多出「明天」。
22 个字里,两张分别对了 20 个和 18 个左右。
单看字数挺高,可整句拿去用一张都用不了。
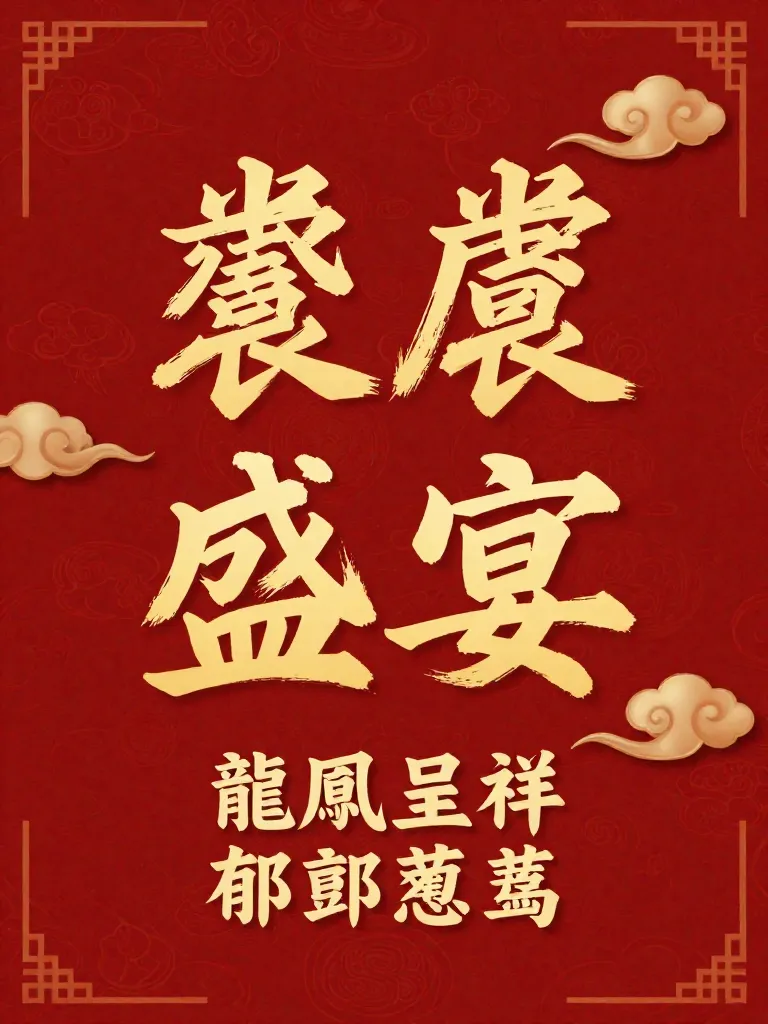
生僻字这档,「饕餮」两张都画成了上半截像、下半截是「衣」的假字。
「鬱鬱蔥蔥」第一个字直接换成了简体的「郁」,后面也有错字。
「盛宴」「龍鳳呈祥」这 6 个字两张都写对了,繁体常用字它认得。
汇总
| 难度 | 完全正确 | 主要错误 |
|---|---|---|
| 4 字标题 | 2/2 | 无 |
| 数字日期海报 | 2/2 | 无 |
| 中英两行 | 0/2 | 中文全对,英文单词拼错 |
| 22 字长句 | 0/2 | 漏字、多字、错字同时出现 |
| 生僻字+繁体 | 0/2 | 编造字形,繁体被换成简体 |
| 第一轮带字的 2 张 | 1/2 | 整行重复、漏字 |
一共 12 张带字的图,5 张完全正确。
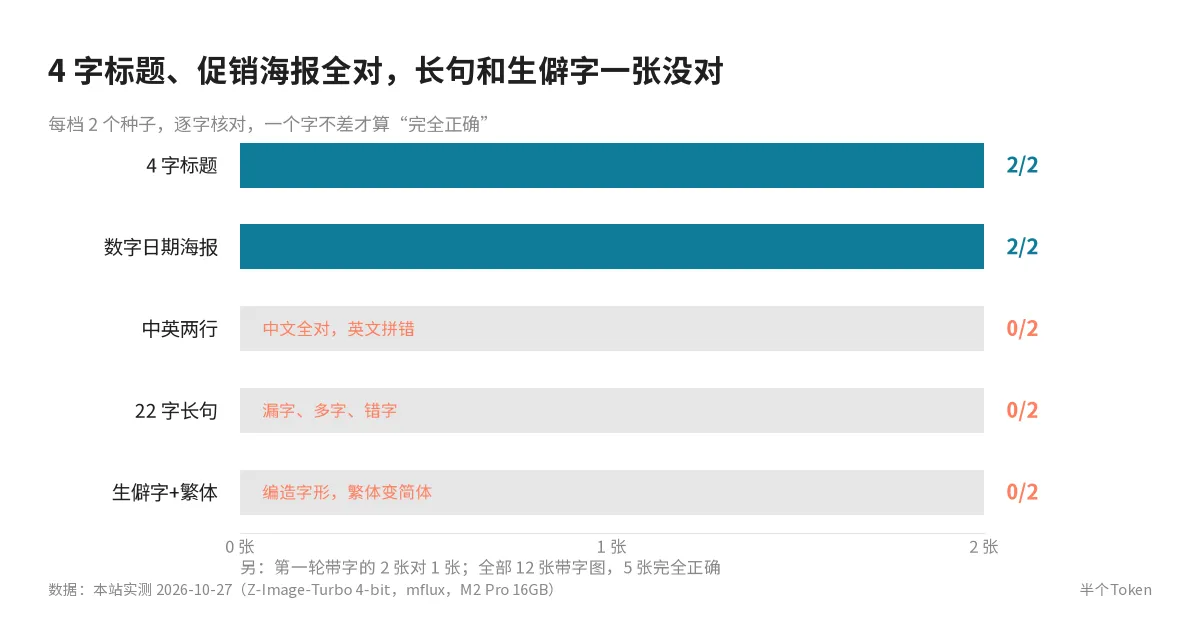 短的两档全对,往下三档一张都没对。
错误类型数下来:多写/重复 3 次,漏字 3 次,错字和编造字形最多,英文拼错 2 次,简繁混用 2 次。
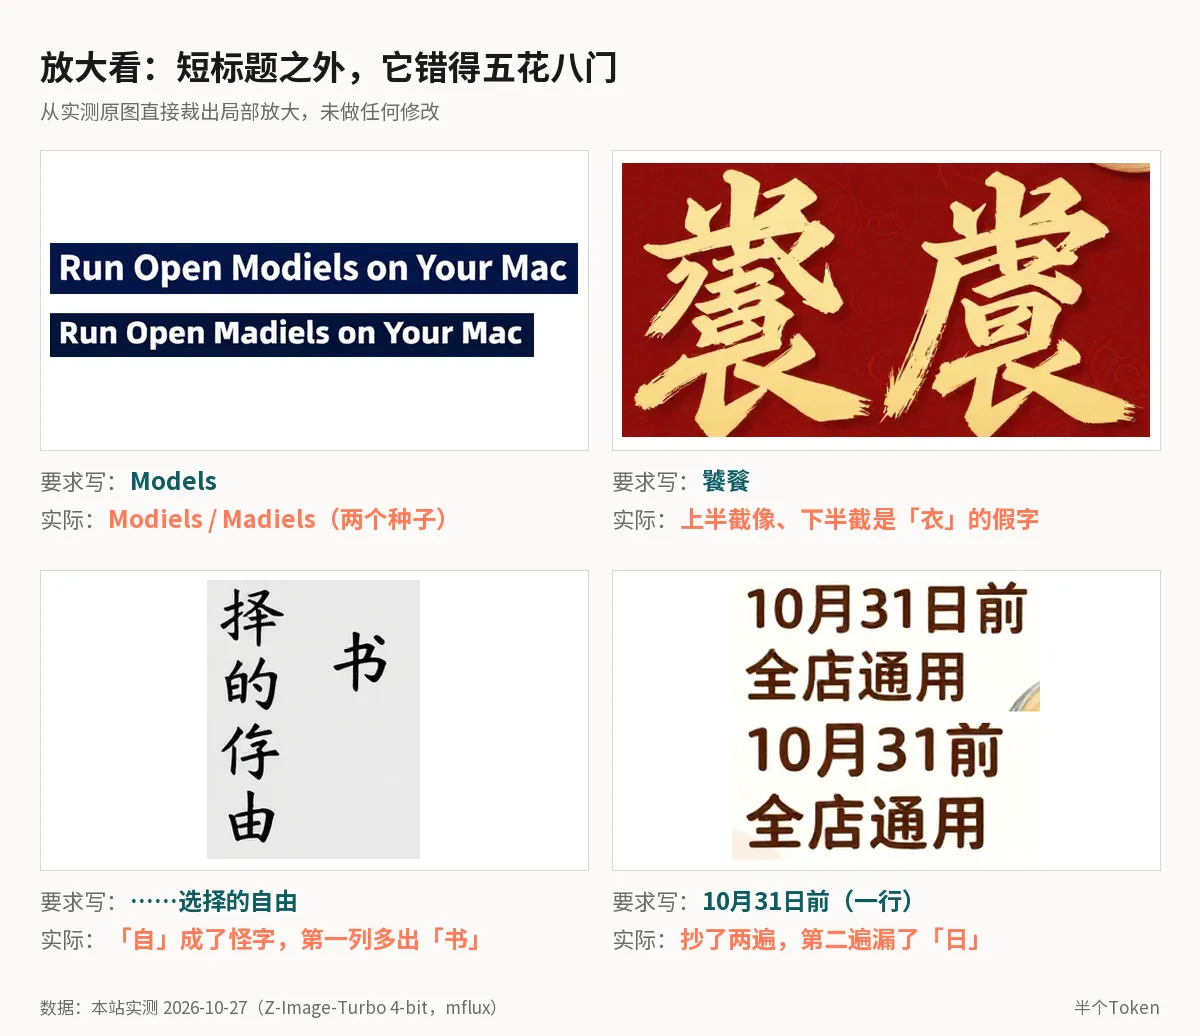 从原图裁出来放大:拼错的英文、造出来的字、多出来的字、抄两遍的日期。
还有一个现象:同一个提示词换种子,构图几乎一样。
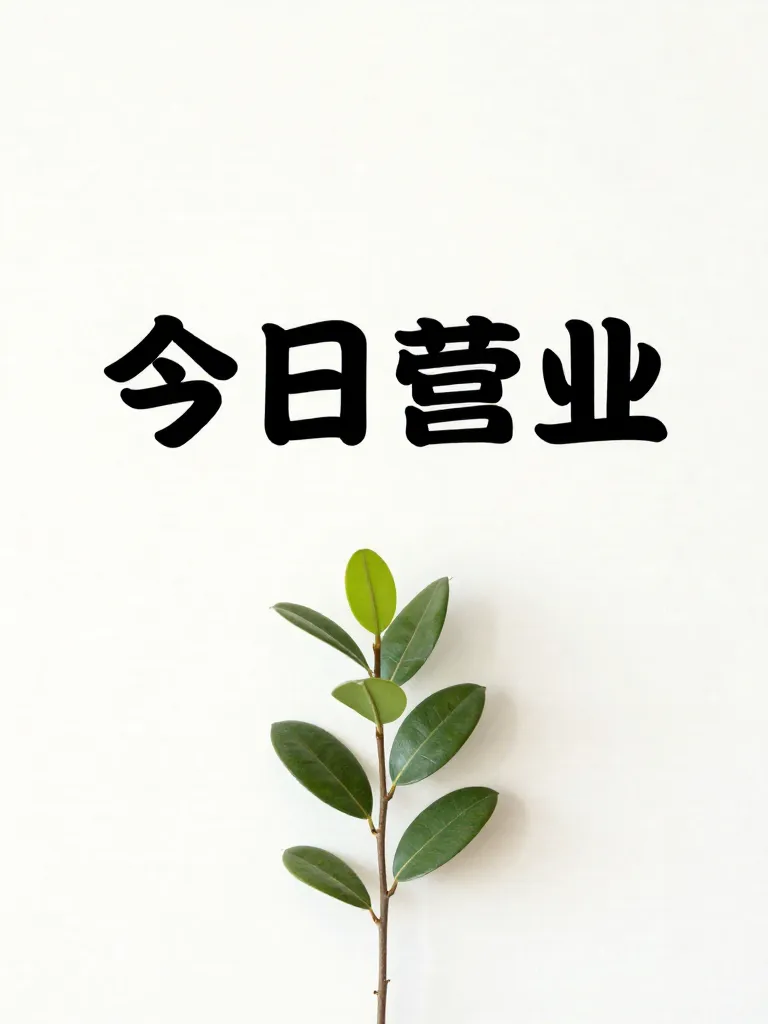
「今日营业」两张,字的位置、那枝叶子,基本是同一张图挪了挪。
官方 GitHub 的模型对比表里,Turbo 那一栏的多样性写的是“低”。
所以字写错了想靠多抽几次碰运气,排版大概率还是那个排版,换的只是错哪个字。
为什么它中文字写得好
这部分主要来自通义团队的技术报告(arXiv 2511.22699),加上英文圈的几篇评测。
文本编码器换成了 Qwen3-4B。
画图模型先得“读懂”提示词,读的那部分叫文本编码器。
FLUX.1 这一代用的是 T5 和 CLIP,英文为主。
Z-Image 直接用了通义自家的 Qwen3-4B 语言模型,报告里给的理由就是它中英双语都强。
训练数据的说明文字先做 OCR。
他们训了一个叫 Z-Captioner 的打标模型,看到一张图先把图里的字认出来,再写描述,而且字保持原文,不翻译。
模型因此学到的是“图里这块写的就是这几个汉字”,这几个汉字没有被翻成英文意思。
报告还提到,中文字的能力主要是在 256×256 低分辨率预训练阶段就学会的,后面又用合成的文字海报数据、针对文字渲染的偏好训练再磨了一遍。
分数确实高。
在多区域文字的 CVTG-2K 测试上,Z-Image-Turbo 的单词准确率 0.8585,GPT Image 1 高质量档 0.8569,Qwen-Image 0.8288,FLUX.1 dev 只有 0.4965。
长文字的 LongText-Bench 中文项,Turbo 0.926,Qwen-Image 0.946,GPT Image 1 只有 0.619。
另一篇今年 5 月的论文(TextAlign)用同一个测试复测,FLUX 的中文分是 0.022,基本等于不会写中文。
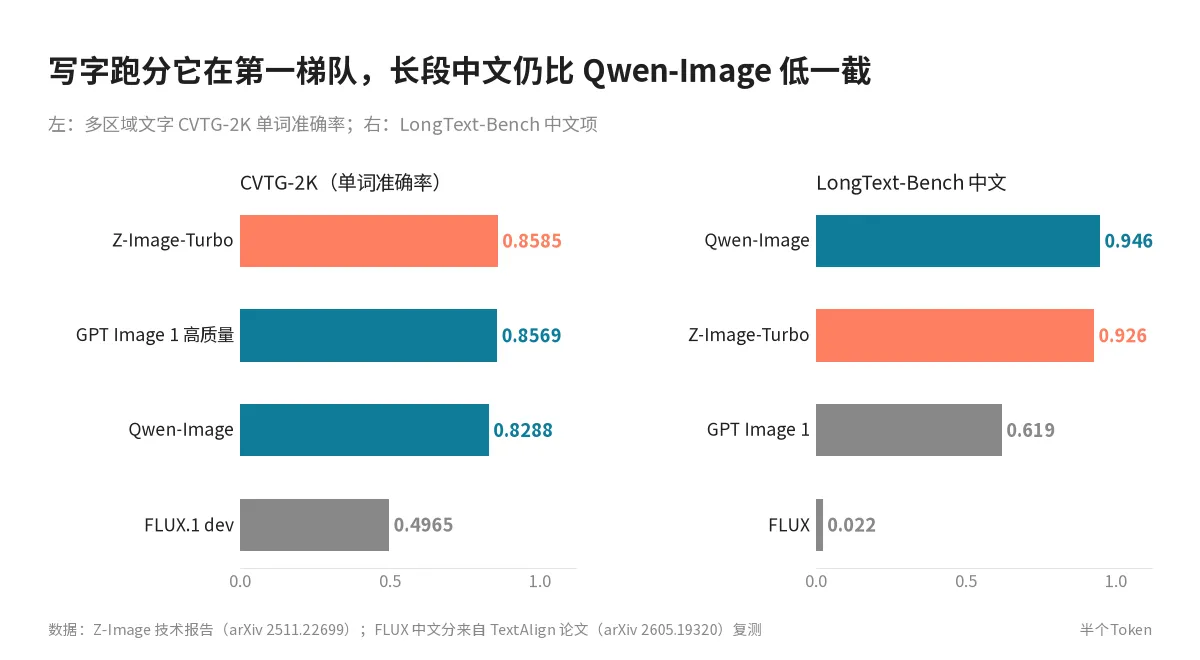 多区域文字它排第一,长段中文还是 Qwen-Image 高一点。
这个分和我们的长句翻车对得上。
0.926 是按字算的平均正确率,我们那张长句 22 个字对了 20 个,大约 0.91,跟论文差不多。
可每个字都有 7% 的机会出错,粗算一下,22 个字全对的概率只有两成左右。
所以“中文字很强”这句宣传对短标题是真的,对整段文案就得打个折,论文分数和你能不能直接发图是两回事。
另外 Qwen-Image 在长文本上还是比它高一截,DEV 社区上 Garyvov 拿两家同种子对比,也说 Qwen-Image-2512 拼写更准。
为什么 6B 这么小还能打
报告里点名的同行,Qwen-Image 20B,FLUX.2 32B,混元图像 3.0 80B。
Z-Image 是 6.15B。
一条流水线处理文字和图。
FLUX、SD3、Qwen-Image 这类“双流”结构,文字和图像各走一套参数,中间再交互。
Z-Image 的 S3-DiT 把文字、图像语义、图像像素三种 token 拼成一串,30 层全部共用一套参数。
团队的说法是每一层都在做跨模态交互,参数利用率更高。
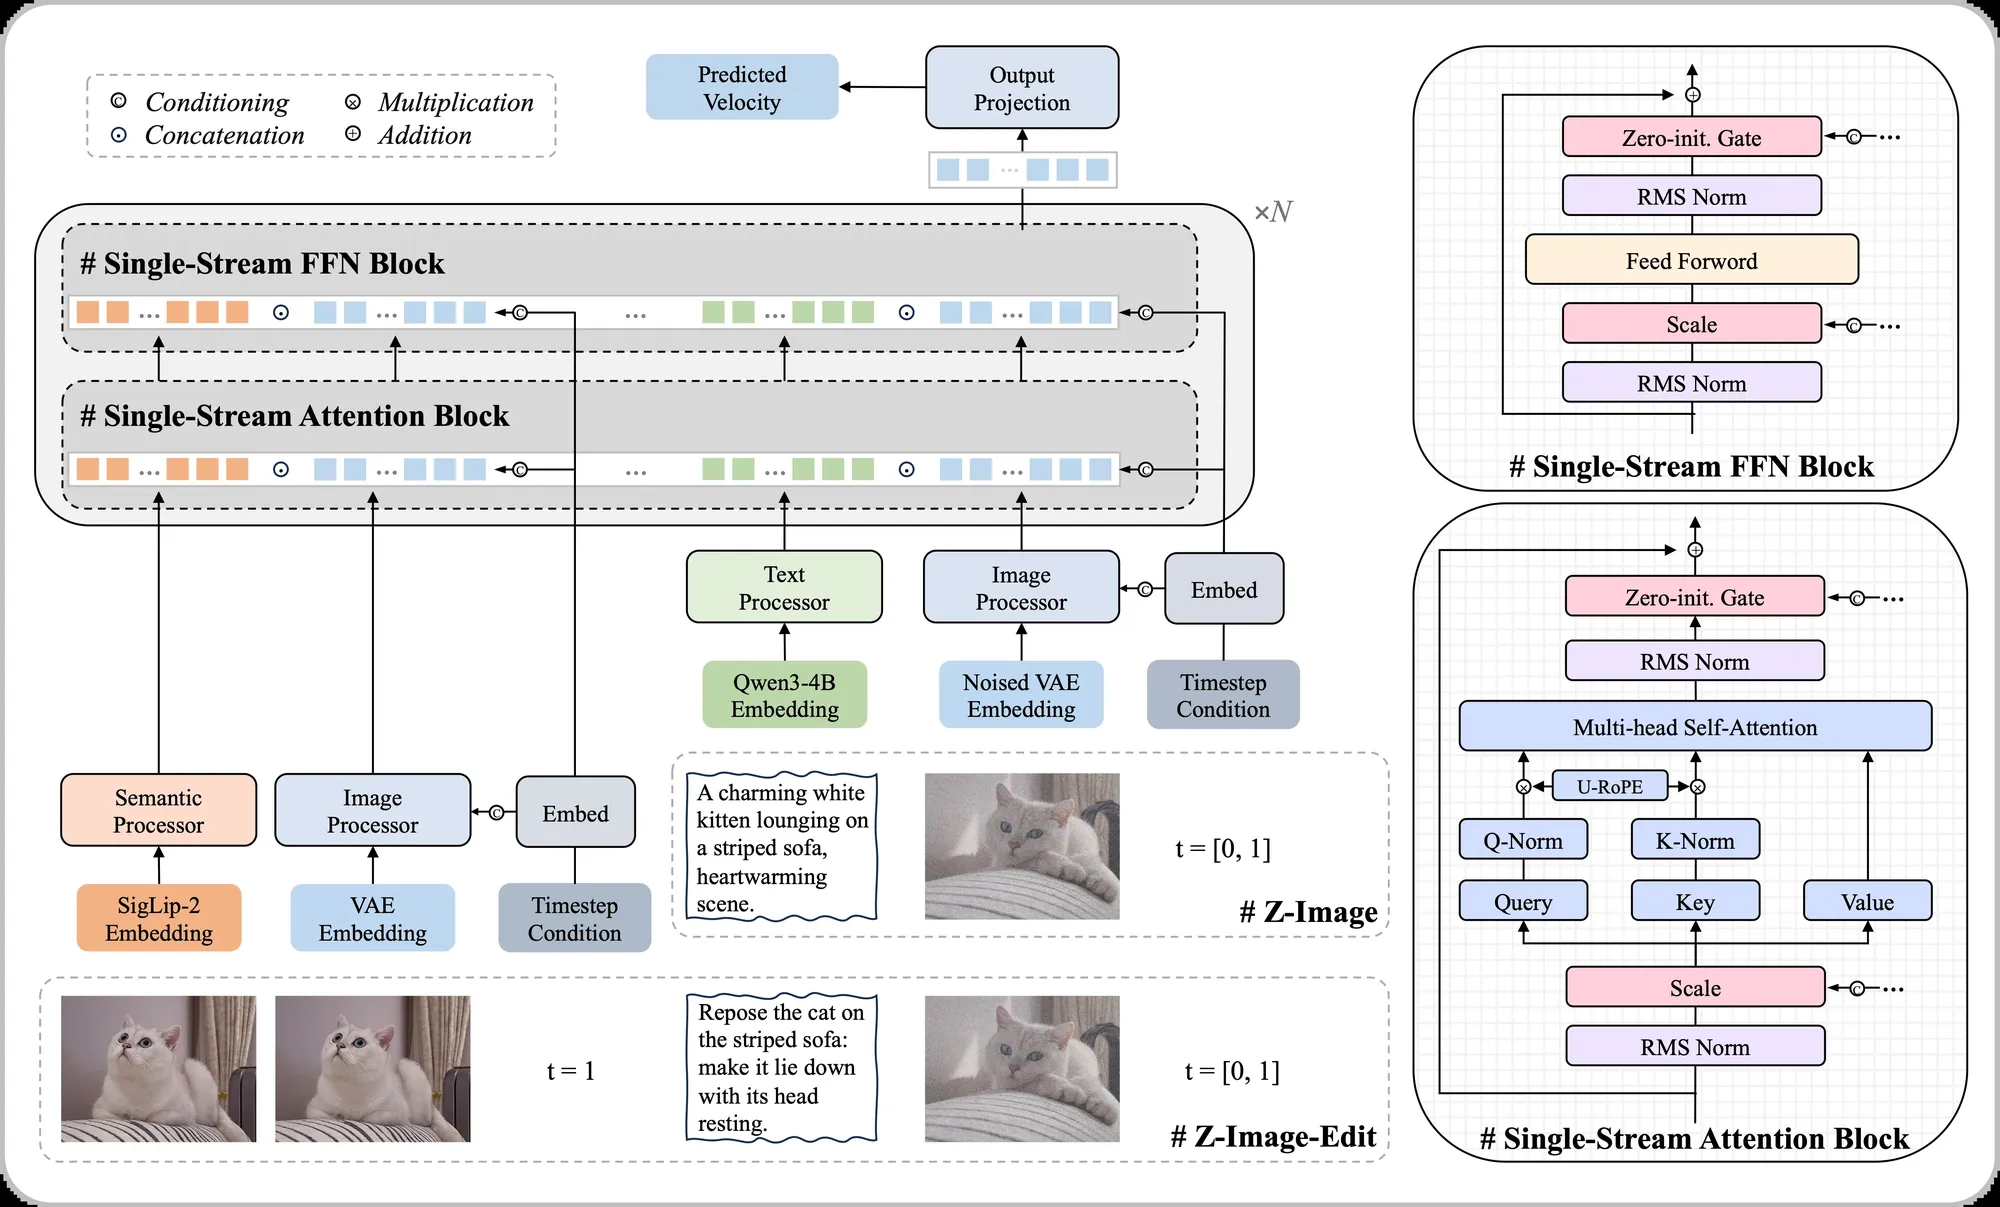 官方架构图:文字、语义、像素三路 token 拼成一串,进同一组单流模块。
蒸馏到 8 步,还省掉了一半计算。
完整版 Z-Image 要大约 100 次前向计算,Turbo 只要 8 次。
用的方法叫 Decoupled DMD,论文标题就很直白:“CFG 增强是矛,分布匹配是盾”。
意思是让少步数出好图的主力其实是 CFG 增强这一项,分布匹配负责防止画崩。
蒸馏完的 Turbo 不再需要 CFG,guidance 设成 0,每一步只算一次,这也是它在消费级显卡上快的原因之一。
训练花了 314K 个 H800 GPU 小时。
报告按每小时约 2 美元算,总共约 62.8 万美元。
这个数是按租卡价折算的,不是审计过的账,但量级上比动辄几百亿参数的模型小得多。
代价报告里也写了。
原话大意是:受限于 6B 的模型规模,世界知识、意图理解、复杂推理都有局限。
他们的补救是在前面加一个带推理链的提示词扩写器,本地 mflux 跑的时候没有这一层。
4-bit 量化、在 Mac 上跑,丢了什么
体积。
mflux 的说明里写,Z-Image 原始权重大约 31GB。
我们用的 4-bit 版下到本地是 5.5GB:图像主干 3.2G,文本编码器 2.1G,VAE 157M。
注意文本编码器也被压了,偏偏就是负责“读懂”中文的那一块。
量化对写字准确率影响多大,量化作者在魔搭上没写说明,我们也没做对照,算未知。
内存。
模型文件 5.5G,跑起来 mflux 自己报的 MLX 峰值 7.8–8.9GB,系统记的整个进程峰值 12.4–12.7GB。
16G 的机器剩下不到 4G,开着浏览器一堆标签页会明显卡。
8G 的 Mac 我们没试,按这个数基本没戏。
速度,差得最多。
官方说在 H800 上不到 1 秒一张,前提是开了 FlashAttention-3 和 torch.compile。
Decrypt 在 6G 显存的 RTX 2060 笔记本上是 34 秒一张。
我们 M2 Pro 补测 10 张平均 130 秒,每一步 12 到 15 秒。
一篇 Apple Silicon 教程在 M1 Max 上用 ComfyUI 跑 1024×1024,也是 160 秒左右,量级一致。
同一个模型,在 Mac 上比数据中心显卡慢一百多倍。
还有 Turbo 本身的限制,跟 Mac 无关。
不吃负面提示词,多样性低,官方表格写明不适合拿来微调。
想训 LoRA 的,要用今年 1 月放出的 Z-Image 完整版。
算账:本地跑到底省多少
先把本机的数摆出来。
出图时整机功耗约 55W,一张 130 秒,折合每张约 0.002 度电。
北京居民第一档电价 0.4883 元/度,一张图电费约 0.001 元。
同一个模型在阿里云百炼上调用,北京地域 0.1 元一张。
Artificial Analysis 上列的第三方 API 价格是 1000 张 5 美元,一张合人民币三四分钱。
Midjourney 最便宜的 Basic 档 10 美元一个月,快速出图时长大约够 200 张左右。
按每月出图量摊一下:
| 每月张数 | 本机电费 | 本机占机时间 | 百炼 API |
|---|---|---|---|
| 30(每天一张封面) | 约 0.03 元 | 约 1 小时 | 3 元 |
| 300 | 约 0.3 元 | 约 11 小时 | 30 元 |
| 3000 | 约 3 元 | 约 108 小时 | 300 元 |
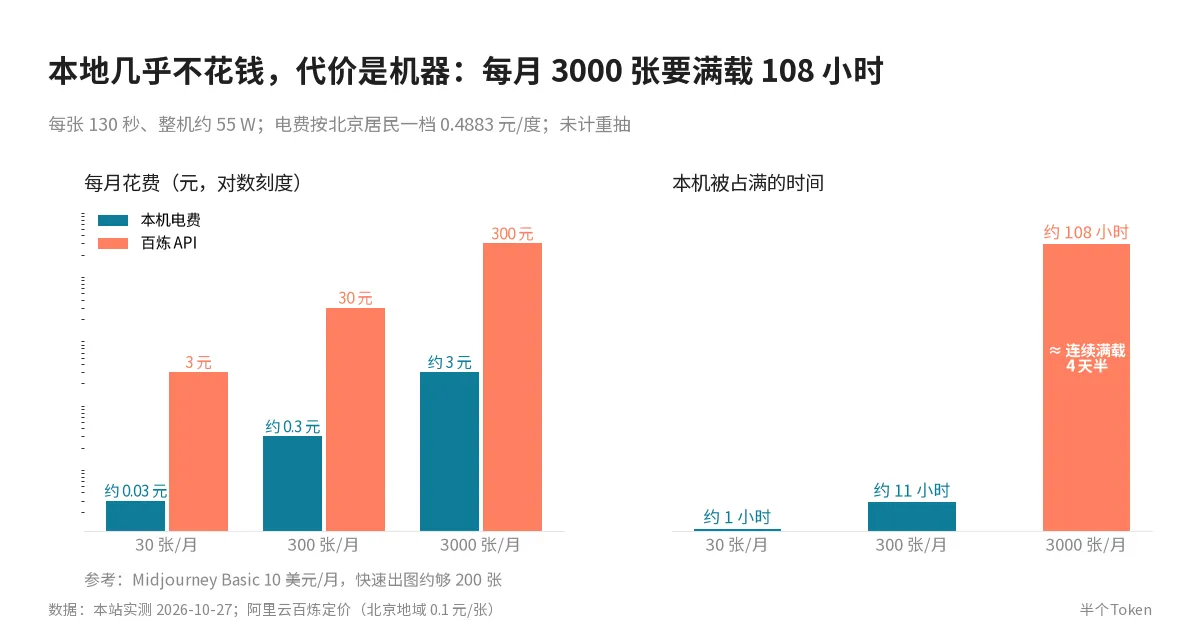 钱上本地几乎为零,真正的成本是机器被占满的时间。
这还没算重抽。
我们 12 张带字的图 5 张全对,真要出一张能发的,平均得抽两三次,本机时间还要再乘一下。
换个算法更直观:本地每张省下约 0.1 元,代价是 2 分多钟机器被占满。
折下来,相当于把这台 Mac 和你的等待按每小时不到 3 块钱卖掉了。
单论钱,本地跑划不来;它真正值钱的地方是图不出本机、不用排队、没有内容审核卡你,想要这几样的人才值得折腾。
每月 3000 张那档,本地要连续满载 4 天半,笔记本基本扛不住,这个量就该上 API 或者租卡。
它在开源圈的位置
去年 11 月 26 日放出来的时候,它是真火过一阵。
12 月 8 日在 Artificial Analysis 文生图榜上排总榜第 8,开源第一。
Decrypt 当时的标题直接写它把 FLUX 拉下了王座,文里说 Civitai 上它收到 1200 多条好评,FLUX.2 是 157 条。
阿里自家的 AI Arena 上它也是开源第一,不过那个榜是阿里自己办的,得打个问号。
十个多月过去,Artificial Analysis 今天的榜上它 Elo 936,排 70 到 76 名。
开源这边,Qwen-Image-2.1、FLUX 3 Image Klein 都到了 1040 上下,FLUX.2 dev 也在 1000。
Elo 是相对分,新模型一多,老模型分数会往下掉,排名掉得这么狠,一部分是这个原因。
但它手里还有两张牌。
一是 Apache 2.0,商用不用另外谈授权,FLUX.1 dev 那种非商用协议做不到这点。
二是小,16G 的 Mac、6G 显存的老 N 卡都能跑,这个门槛至今没几个开源模型比它低。
如果你的需求就是本地、免费、能写中文短标题,它到今天还是最省事的那个;要画质天花板或者长文案,开源里已经有更好的选择,只是你的电脑大概率跑不动。
怎么装
- 装 mflux:
uv tool install --python 3.13 mflux==0.23.0 --with pillow==12.3.0(Pillow 13 跟它不兼容) - 从魔搭下载 4-bit 量化模型:
Jiangdi/Z-Image-Turbo-mflux-4bit - 出图:
mflux-generate-z-image-turbo --model <模型目录> --base-model z-image-turbo --steps 9 --width 768 --height 1024 --seed 1 --prompt "<你要的画面>"
提示词里要写的字用「」括起来;常用字、一行十个字以内的标题,我们这次都是一次写对。
14 张图和耗时、内存、功耗记录均为本站 2026-10-27 实测。